OCR for PDF
PDF 로 스캔한 책이 많이 있는데, OCR로 텍스트 인식은 되어 있지 않다. (600DPI 이미지형태)
그래서인지 용량이 꽤 크다, 1권당 몇 기가?
일단은 검색도 되게 하고, 용량도 절약할 겸 OCR을 한번 만들어본다.
처음에는, PaddleOCR을 써봤는데, 인식률이 그렇게 만족스럽지 않았다
좀 찾아보니, 최근 PaddleOCR-VL이라는것도 새로 나왔길래, 테스트 해 봤는데 꽤 괜찮다.
PaddleOCR - 文档解析与智能文字识别 | 支持API调用与MCP服务 - 飞桨星河社区
conda activate ocr310아래는 샘플 페이지 및 인식 결과 (HTML로 output 생성)
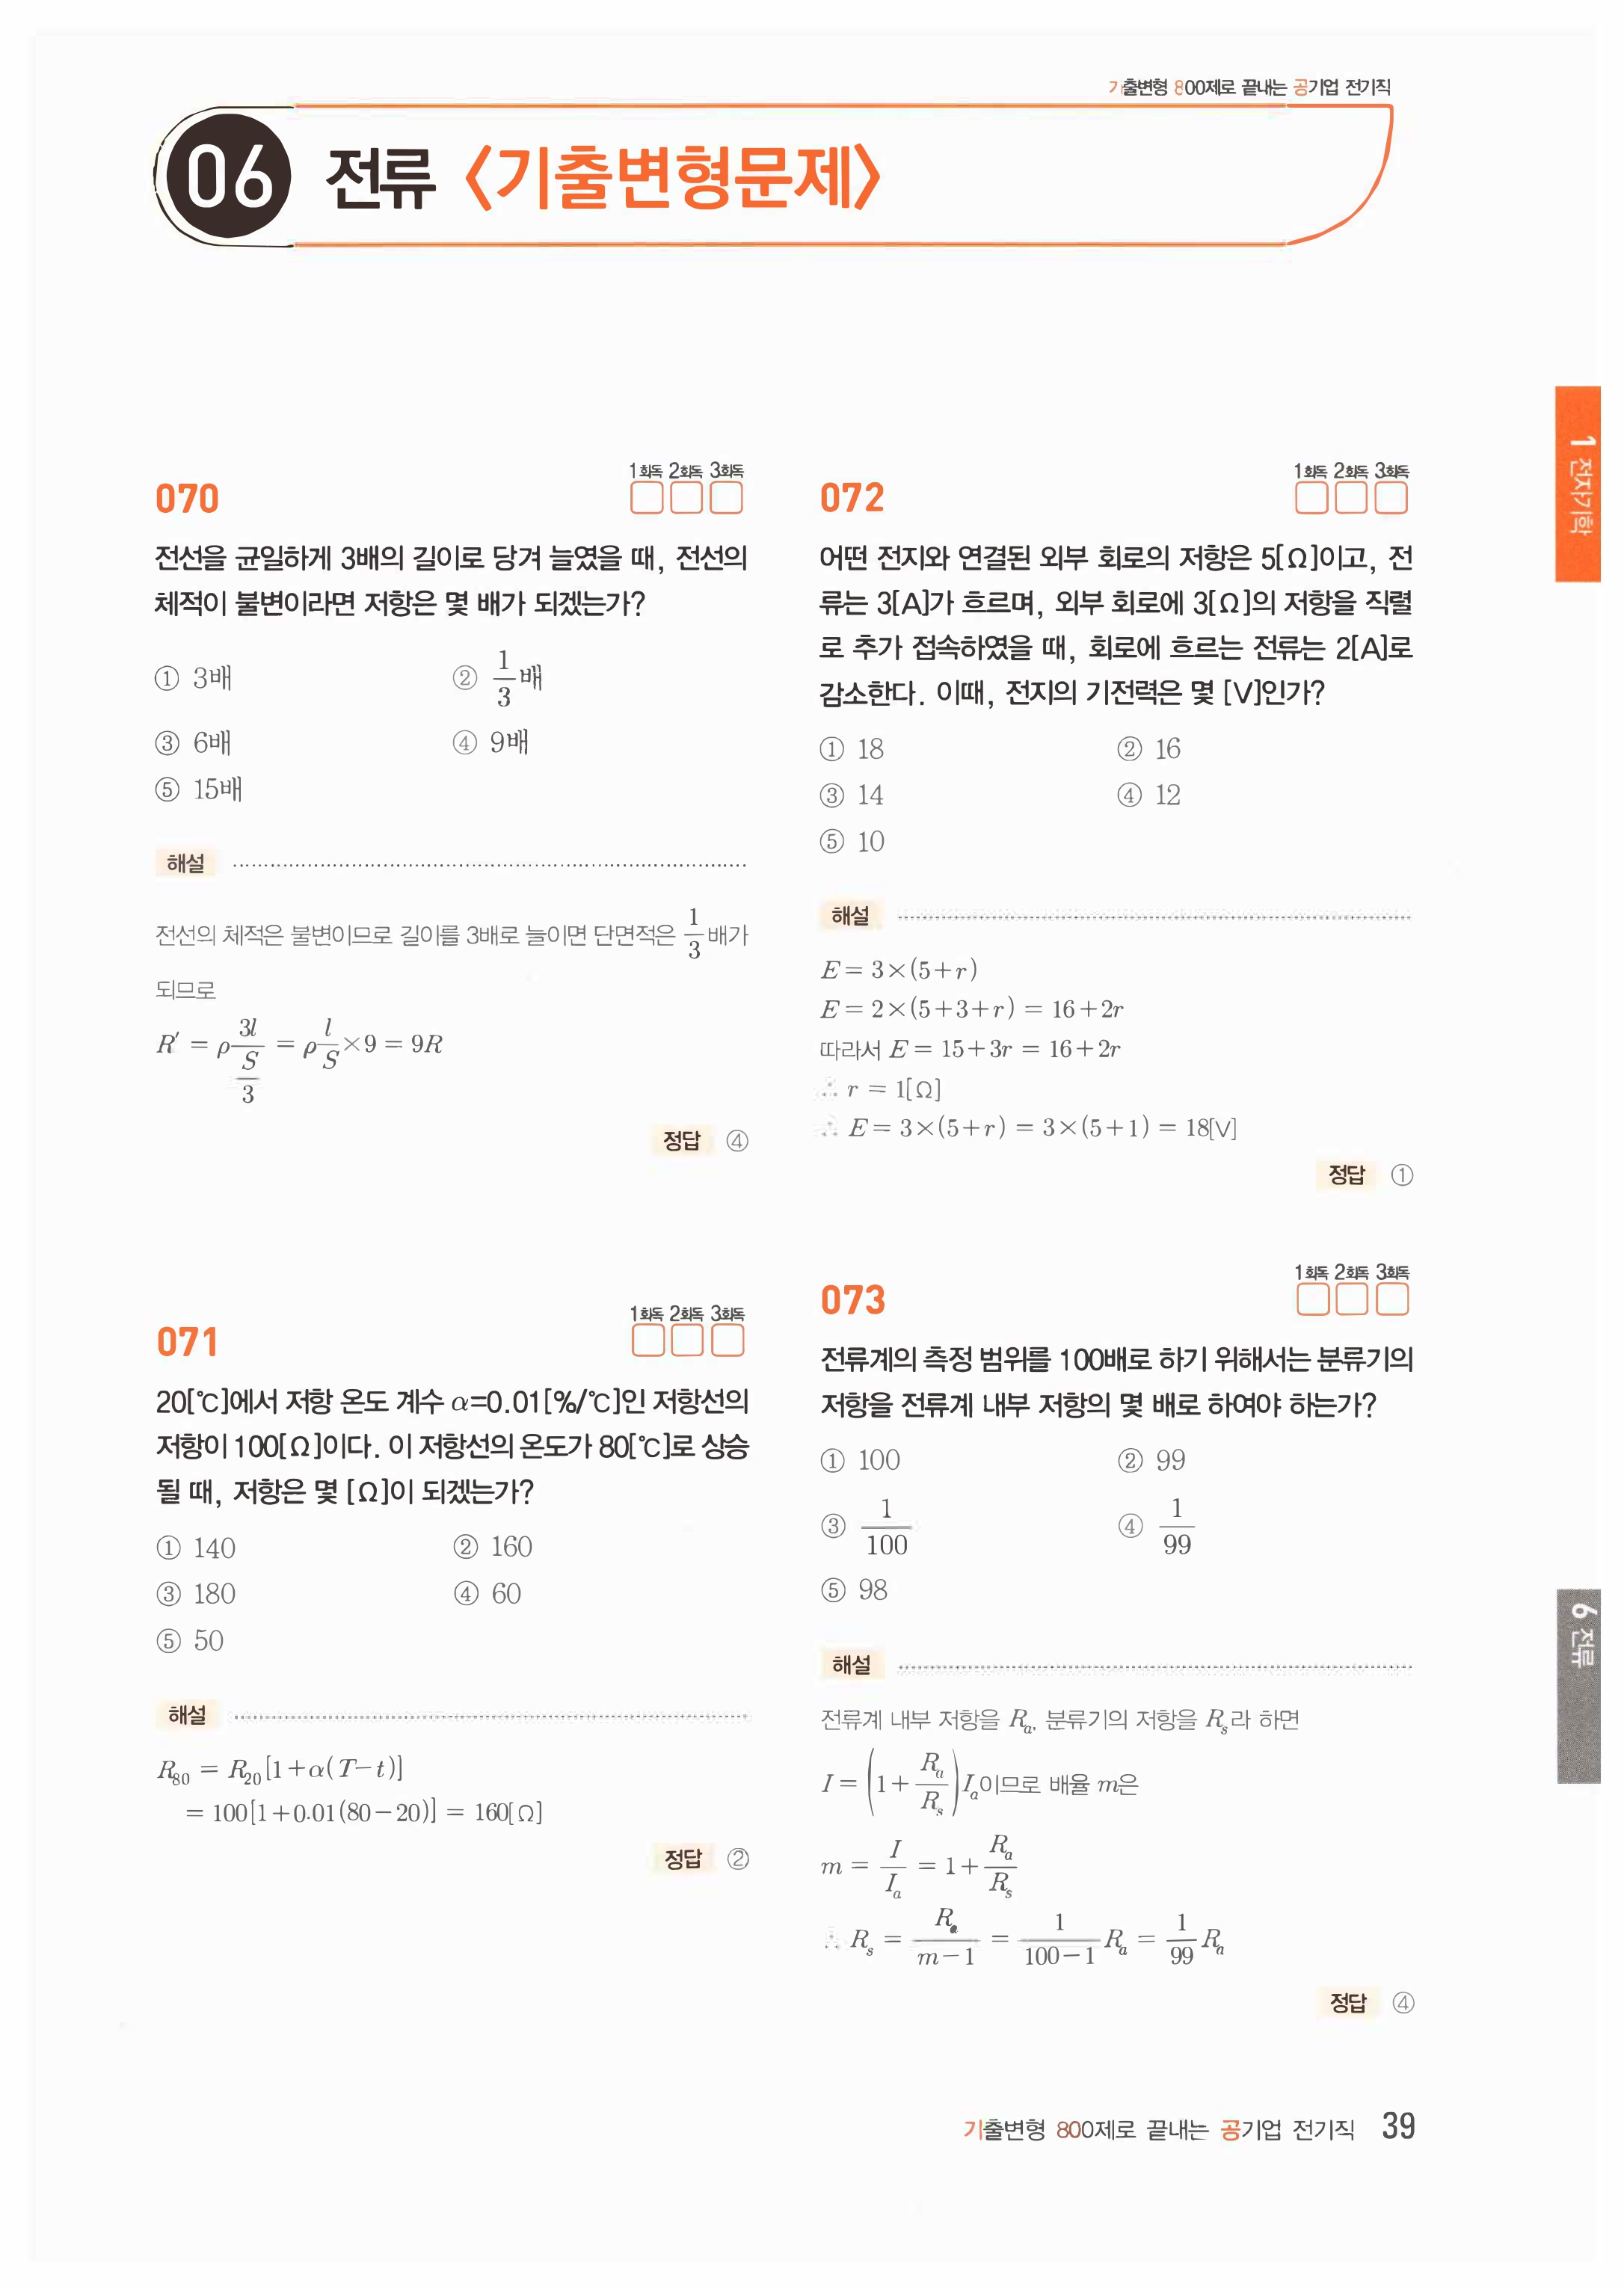
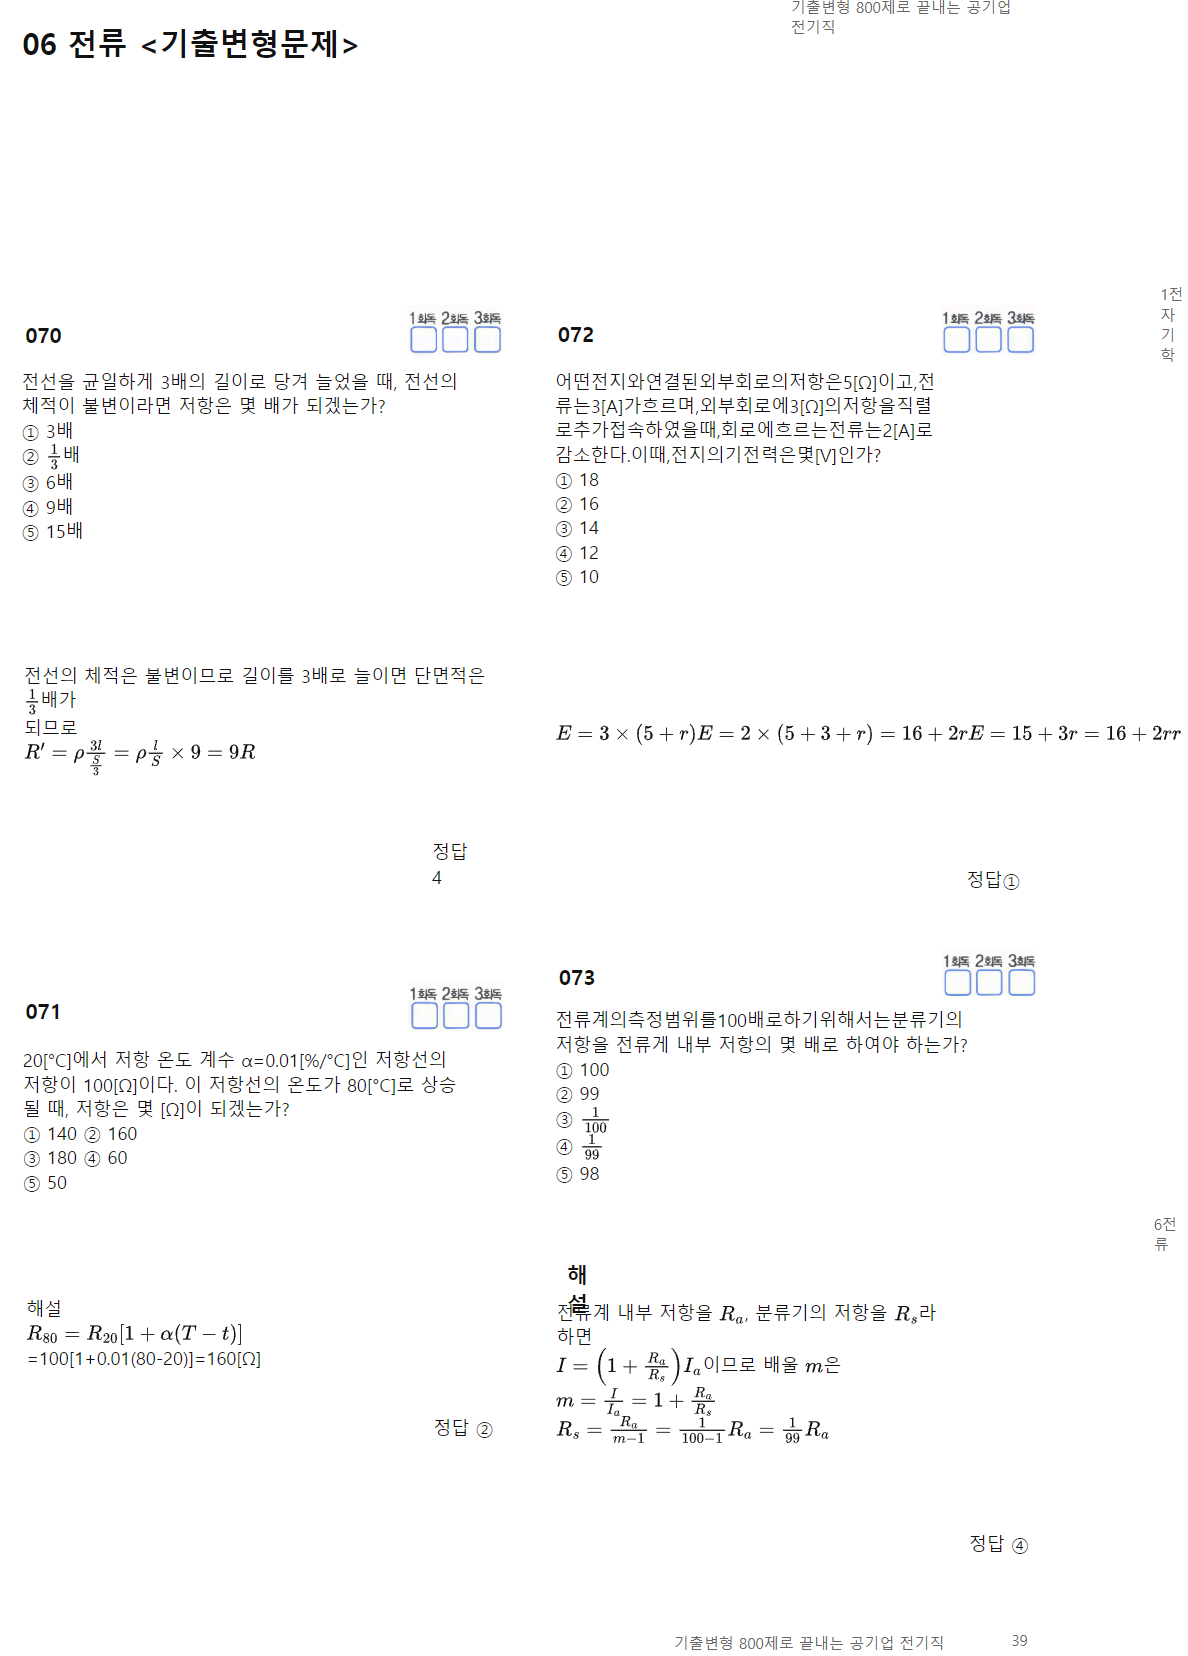
마지막 수정